AI-基模有哪些:九类基础模型与它们的能力边界
“基模”这个词在中文 AI 语境里出现频率很高,但经常混着两件事:一是 foundation model,指大规模预训练、能迁移到大量下游任务的通用底座;二是 base model,指相对于 instruct / chat 版本、还没做指令微调的底模。前者是一种模型类别,后者是训练流程里的一个阶段。
本文按前者讲,但会把后者的区别说清楚。因为实际选型时踩的坑,大多来自把这两件事当成了一回事:拿一个 base model 当产品用,或者以为换个更大的基模就能解决格式不稳、事实不准的问题。
1. 什么才算基模
最常见的误判是把“参数多”当成判据。参数只是结果,不是定义。
判断一个模型是不是基模,看四条:
- 训练信号和任务解耦。 预训练目标(预测下一个 token、去噪、对比学习、掩码重建)本身不是任何一个下游任务。任务是在权重已经形成之后才接上去的。
- 一份权重覆盖多任务。 换提示、换少量样本、加一个轻量适配层就能改用途,而不是重新训练一个网络。
- 可以被当成组件复用。 它的中间表示能被别的系统拿去用——CLIP 的视觉塔被无数多模态模型复用,Whisper 的编码器被大量语音流水线复用,这就是基模最典型的特征。
- 规模收益仍然存在。 加数据、加算力,损失曲线还没平。一旦平了,它就更像一件成熟工具,而不是还在演进的底座。
反例很清楚:一个超分网络、一个缺陷检测分类器、一个语音降噪模型,都不算基模。它们的任务就是目标函数本身,输入输出都是固定的,没有“迁移”这回事。
所以更准确的说法是:基模把“任务”从“目标函数”里拿掉了,留下的是一个关于世界如何组织的先验,任务在推理时才由提示、条件或少量数据指定。
base model 与 foundation model 的区别
这个区别最好用一条流水线来说明。
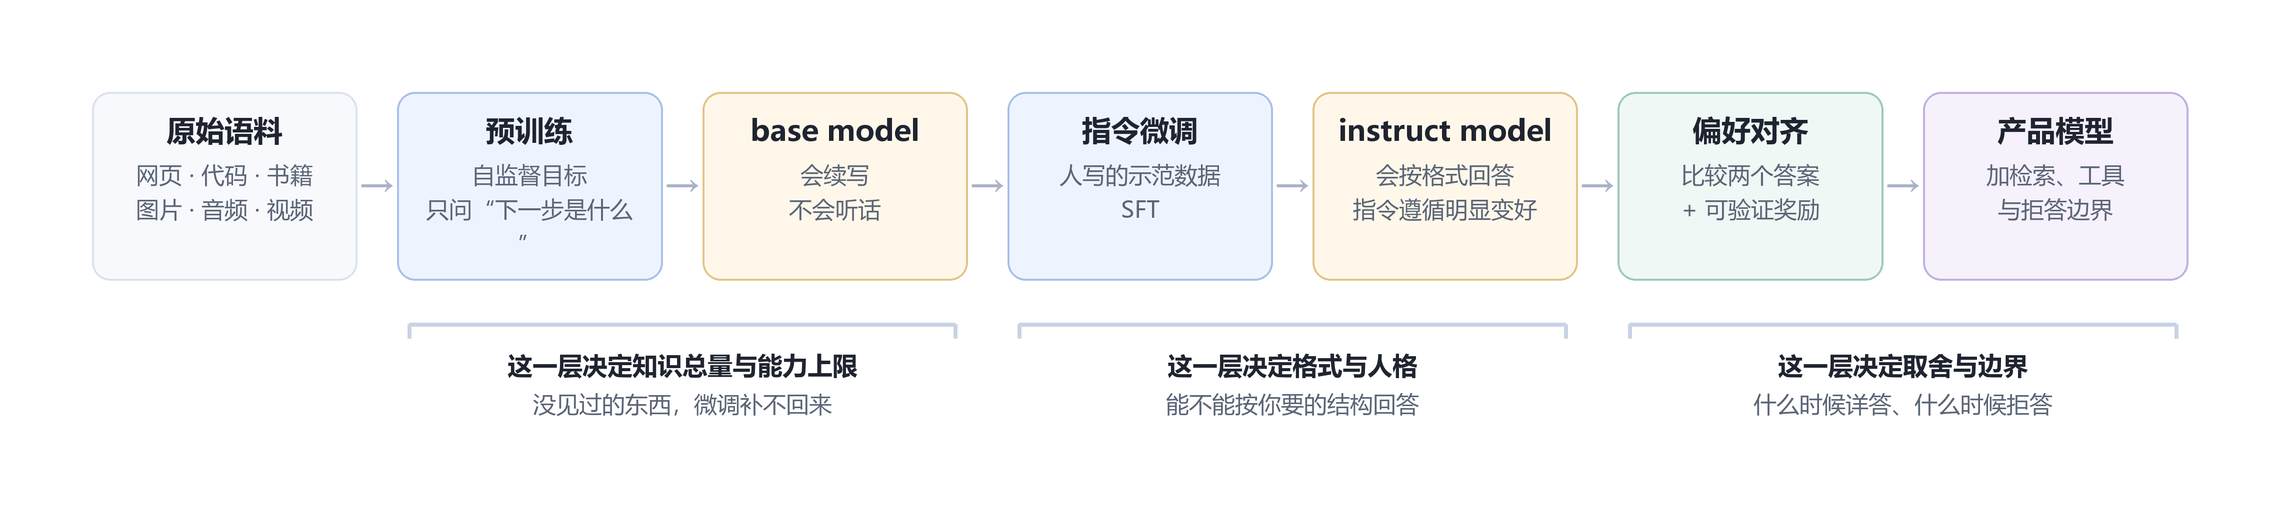
图 1 三段流程解决的是三个不同的问题:第一层定知识总量与能力上限,第二层定格式与人格,第三层定取舍与边界。
这里有两个常被忽略的事实。
第一,base model 的能力上限决定了后训练能榨出多少。后训练改的是行为的分布和偏好,不是知识的总量。一个在预训练阶段没见过某类结构(比如某种代码方言、某种语言的排版)的底模,靠微调补不回来。
第二,对齐是有代价的。为了让模型“听话”,通常会牺牲一部分发散性和知识密度。这就是为什么有些写作、创意类任务反而在较弱对齐的模型上效果更好。
2. 一张全景图:两个轴,九类底座
按模态罗列模型没有解释力,因为“文本模型”和“视频模型”的差别远不只是数据不同。更有用的分法是看两个轴。
轴 A:输出什么。 文本、向量、图像、视频、音频、三维结构、动作、数值。
轴 B:用什么信号训练。 下一 token 预测、掩码重建、对比学习、去噪、偏好与可验证奖励、物理仿真。
这两个轴基本决定了模型的能力形状:用“补全”信号训练出来的模型擅长续写和联想,用“去噪”信号训练出来的模型擅长从模糊条件生成,用“对比”信号训练出来的模型擅长判别和检索但不擅长生成,用“动作”信号训练出来的模型必须和真实环境闭环。
把这两个轴叠起来,就有了下面这张表。后面九节逐一展开。
| 类别 | 输入 | 输出 | 主要训练信号 | 代表 |
|---|---|---|---|---|
| 语言基模 | 文本、代码、工具返回 | 文本、结构化调用 | 下一 token 预测 | GPT、Claude、Gemini、Qwen、DeepSeek、Llama |
| 视觉表征基模 | 图像、图文对 | 向量 | 对比 / 自蒸馏 | CLIP、SigLIP、DINOv2 |
| 视觉语言基模 | 图像、视频帧 + 文本 | 文本、坐标 | 图文对齐 + 指令微调 | Gemini、GPT 视觉、Qwen-VL、InternVL |
| 图像生成基模 | 文本、参考图、结构图 | 像素 | 去噪 / 流匹配 | Stable Diffusion、Flux、Imagen、Seedream |
| 视频生成基模 | 文本、首尾帧 | 视频 | 时空去噪 | Sora、Veo、可灵、Wan、Vidu |
| 语音音频基模 | 波形、文本 | 波形、离散音频 token | 预测 / 去噪 / 对比 | Whisper、CosyVoice、Suno、Moshi |
| 三维基模 | 图像、文本、点云 | 网格、高斯、场 | 多视图重建 / 前馈回归 | LRM 系、TripoSG、TRELLIS |
| 世界模型与具身基模 | 观测、指令、历史 | 动作、下一状态 | 模仿学习 / 视频预测 | RT-2、π0、GR00T、Genie、Cosmos |
| 科学与数值基模 | 序列、结构、表格 | 数值、结构 | 自监督 + 物理约束 | AlphaFold、ESM、GraphCast、TimesFM、TabPFN |
再看一眼同一组模型,换一个组织方式会更清楚:按“产物是什么东西”,这九类可以归成三层。
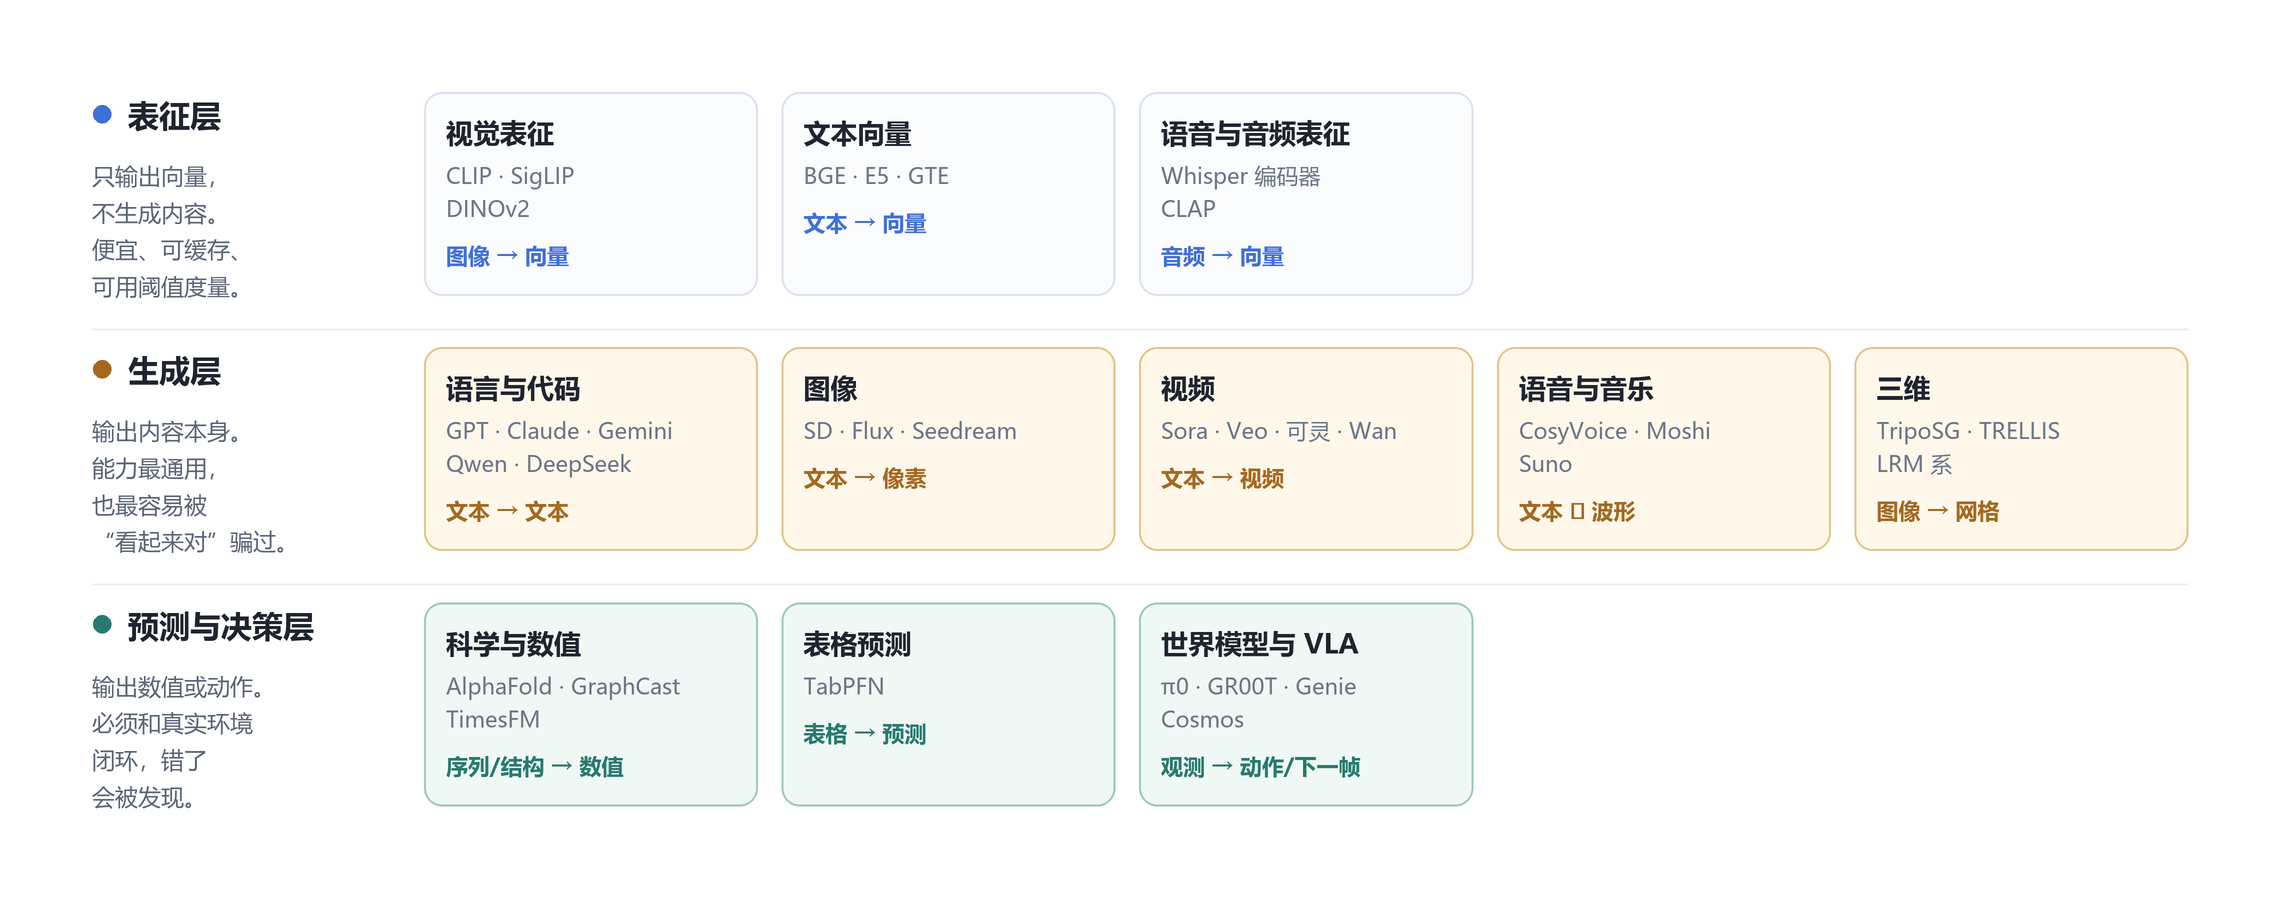
图 2 三层全景。表征层的产物是向量,生成层的产物是内容,预测与决策层的产物是判断和动作。
一句可以记住的抽象:所有基模都是“编码器 + 先验 + 解码器”。 编码器把一种信号压成表示,先验藏在权重里,解码器把表示还原成你需要的形式。类别之间的差别,本质上是“编码什么信号”和“还原成什么形式”。
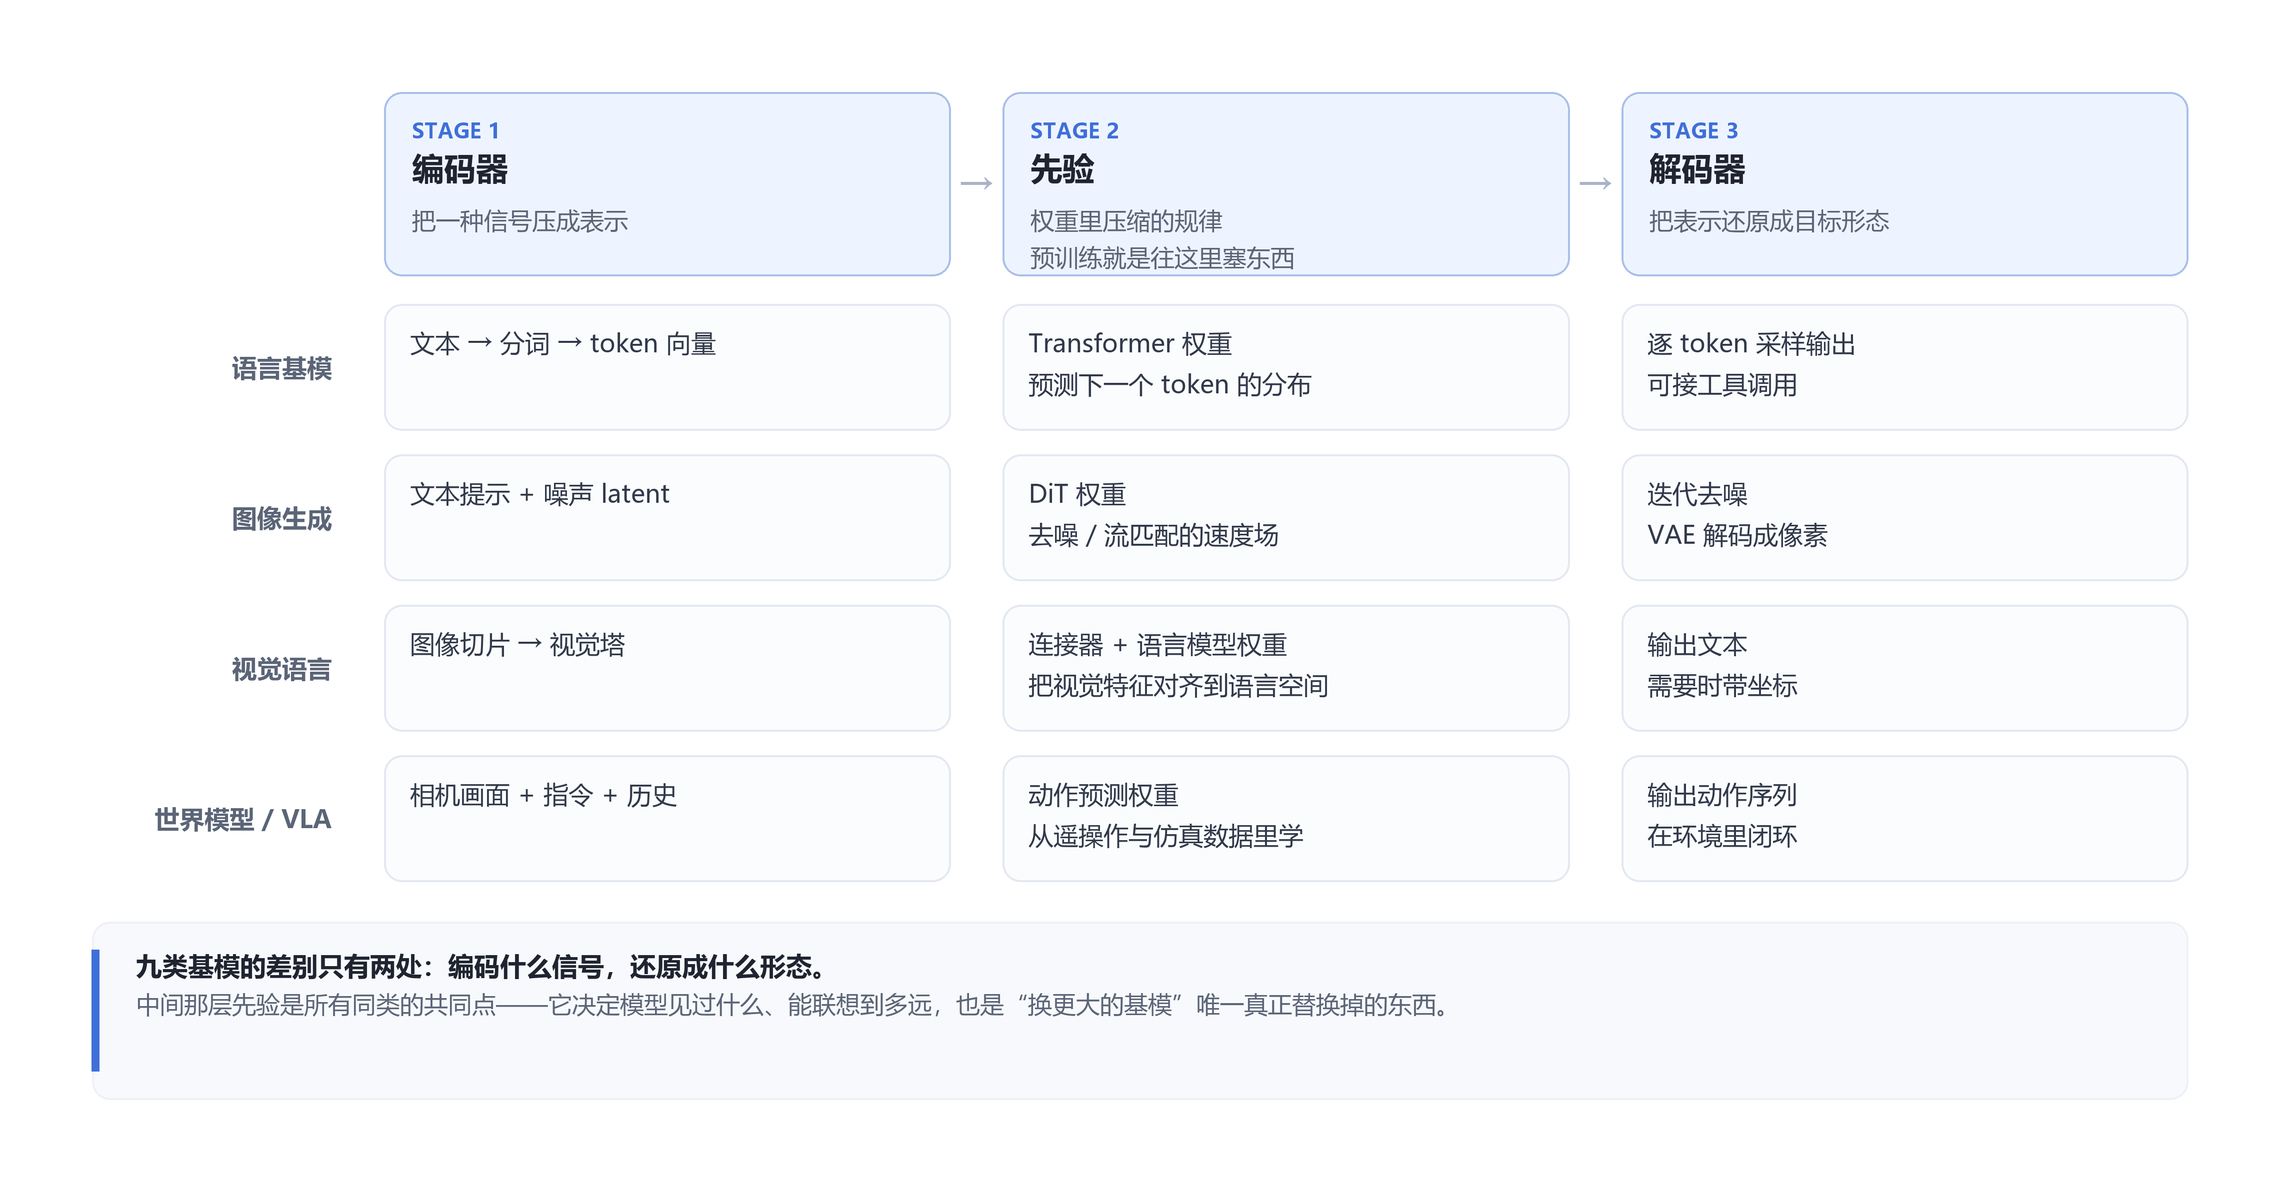
图 3 同一个结构,四种填充方式。看懂这张图,再遇到新的模型类别就不用重新学一遍。
3. 语言基模:最通用的编排层
训练目标是把一段文本的下一个 token 概率分布预测准。这件事之所以能撑起通用能力,是因为要压低大量不同领域的文本的困惑度,模型必须在参数里压缩语法、概念关系、常识事实和解题模式。
架构上,今天的语言基模基本都是 Transformer 的变体。几个值得单独理解的工程点:
稠密模型与 MoE。 稠密模型每个 token 都会用到全部参数。MoE 用路由把 token 分给少数专家,于是“总参数量”和“每个 token 的计算量”被解耦了。以 DeepSeek-V3 为例,671B 总参数、每 token 激活约 37B。要理解的是:MoE 换的是容量,不是免费的知识线性增长——路由本身会不稳,专家利用率会不均,微调时也更容易崩。
上下文长度。 注意力的成本随长度平方增长,KV cache 的显存随长度线性增长。所以“支持 1M 上下文”通常意味着某种折中:稀疏注意力、分块、或者代价很高的显存占用。更重要的经验是,长上下文不等于长程可靠——中间位置的信息被利用的效率明显低于开头和结尾,这就是常说的 lost in the middle。
后训练的三层。 指令微调管格式和人格,偏好优化管取舍,可验证奖励的强化学习管正确性(数学、代码这类能自动判对错的领域)。这三层解决的问题不一样,混在一起谈“模型变强了”,就会分不清是知识涨了还是行为改了。
推理模型。 把算力从训练阶段移到推理阶段:让模型先写一段思考过程再给答案。收益在数学、代码、多步规划上非常明显,代价是延迟和成本成倍增加,而且在简单任务上是纯浪费。所以现在的产品普遍是“先判断难度,再决定思考预算”。
代表的家族不用列版本号,记住阵营就够:闭源侧 GPT、Claude、Gemini 三家,开源侧 Llama、Qwen、DeepSeek、GLM、Mistral、Kimi 这一批。近两年的一个明显变化是,开源权重的模型在通用能力上已经能跟上闭源一档,差距更多体现在长尾任务、工具生态和多模态整合度上。
边界。 语言基模的四类典型失败:
- 幻觉:生成的是统计上合理的后续,不是从事实库里查出来的答案。信息缺失时它倾向于补全,而不是说不知道。
- 知识截止:参数里的知识不方便精确更新,时效性问题必须外接检索。
- 精确计算:算术、计数、日期推演这类需要确定性的操作,交给程序比交给模型可靠。
- 格式脆性:对没见过的模板、超出训练分布的嵌套结构,稳定性会突然下降。
结论是:语言基模是目前最通用的编排层,但不是最可靠的计算层。它的价值在于理解意图、拆解任务、调用工具,而不是自己算出那个数。
4. 视觉表征基模:不生成,只给向量
这一类经常被忽略,但在工程上可能是性价比最高的。
代表是 CLIP / SigLIP 的双塔对比学习(图像和文本各自编码,让匹配的图文对在向量空间靠近),以及 DINOv2 / DINOv3 的自蒸馏(不用标签,靠教师-学生一致性学出对遮挡、光照、视角稳健的特征)。
它的输出不是像素,是一个向量。用途是检索、去重、聚类、分类、异常检测,以及给其他模型当视觉骨干——包括给深度、法线、分割这类任务做冻结特征加轻量头。
同一个思路也用在别的模态上:文本侧的 BGE、E5、GTE 输出的文本向量,音频侧的 CLAP 把声音和文字对到同一个空间,本质都是“编码成向量,不做生成”。
为什么它常比生成模型实用:
- 便宜。 一次前向就是一次编码,可以批量、可以缓存、可以提前算好入库。
- 可度量。 相似度有明确阈值,能画 ROC 曲线,能用业务指标调。生成模型没法这样评估。
- 不会幻觉。 因为它不生成任何东西,最坏情况是排错序,而不是编造内容。
边界也很清楚:细粒度的空间关系、图里的文字、精确计数、多物体之间的属性绑定,这些正是对比学习最弱的地方(模型可能知道图里有“红帽子”和“蓝衣服”,但分不清谁穿谁)。另外,不同模型、不同版本之间的向量不通用,换模型必须重建索引,这一点在长期项目里是真实的迁移成本。
5. 视觉语言基模:把图变成可对话的输入
结构上通常是三段:一个视觉编码器(常常就是上一节的表征基模)、一个把视觉特征对齐到语言空间的连接器(投影层或重采样器)、一个语言基模作为解码器。
训练也是三段:大规模图文对做对齐,指令数据做能力,偏好数据做语气和拒答。
它真正改变了什么?把“看图”从一项专门任务变成了语言模型的一种输入。于是文档理解、图表读数、UI 界面理解、工业质检的报告生成,都能用同一套接口做。对 Agent 来说这一步尤其关键——能读屏,才能操作软件。
边界要注意四点:
- 分辨率与 OCR。 小字、密集表格、公式,本质上是采样问题。工程上靠切图(把大图分块送入)、提高输入分辨率、或者直接接一个专用 OCR。
- “看”是采样后的看。 视频输入通常是抽帧,帧与帧之间的动作、因果、时序关系会丢。抽帧策略对结果的影响,往往比换模型更大。
- 空间与测量的脆弱性。 “左边第二个”“大约三厘米”“一共几个”这类问题,答对的稳定性远低于描述性问答。
- 过度自信。 看图说话的语气和它读图的准确率不匹配,这是这类模型最容易误导人的地方。
工程接口上还有一个容易被低估的能力:坐标输出(grounding)。能返回框或点,才能做后续的裁剪、点击、标注。这是把 VLM 从“问答”变成“流水线组件”的分水岭。
6. 图像生成基模:从噪声里还原条件
主流路线是扩散:从纯噪声出发,逐步去噪,每一步都让结果更像数据分布。产品化的关键一步是潜空间扩散(在压缩后的 latent 上做,而不是在像素上做),这让高分辨率生成的算力降到可接受。
架构上,早期用 U-Net,现在主流是 DiT(Diffusion Transformer),把 latent 切成 patch 当 token 处理。训练目标则从预测噪声逐渐转向流匹配(flow matching / rectified flow)——本质是学一个从噪声到数据的连续速度场,采样路径更直,步数可以更少。
另一条路线是自回归:把图像离散成 token,用语言模型的方式逐个预测。它在和文本模型统一架构上有优势,早期在分辨率和细节上吃亏,现在两条路线的差距在缩小。
控制手段值得单独记住,因为实际工作里“能不能控”比“好不好看”重要:
| 控制方式 | 输入 | 用途 |
|---|---|---|
| 文本提示 | 自然语言 | 内容与风格 |
| 结构条件 | 深度、边缘、姿态、分割 | 构图与人体对齐 |
| 参考图 / IP 适配 | 一张或几张图 | 角色、风格一致性 |
| 局部重绘 | 蒙版 + 提示 | 修图、改局部 |
| LoRA | 几十张图微调 | 固定风格或特定对象 |
代表模型按阵营分:开源的 Stable Diffusion 系与 Flux,闭源或云服务的 Imagen、Seedream、Midjourney、Qwen-Image。工程上真正拉开差距的往往不是基模,而是蒸馏加速(把 30 步压到 4 步)、批量调度、种子复现和许可条款。
边界:精确的文字排版(在改善但还不稳)、精确的空间布局(“把杯子放在盘子左前方 10 厘米”)、多图之间的一致性、以及物理与三维的合理性。这些恰好是 3D 和排版类任务最需要的,所以图像基模在游戏和设计管线里通常只承担“概念与外观资产”这一段。
7. 视频生成基模:把时间当成第三个维度
技术上是图像扩散的直接延伸:用 3D VAE 把视频压成时空 latent,再切成时空 patch 交给 DiT 去噪。所以它继承图像生成的全部控制手段,外加时间维度上的条件——首帧、首尾帧、镜头运动、参考视频。
真正的壁垒不在架构,在数据与算力:需要有字幕的高质量视频、需要能处理长序列的显存、需要对运动幅度做稳定的建模。
能力边界比图像更明显:
- 单镜头几秒到十几秒是舒适区,再长就要靠分段拼接,拼接处的连贯性会掉。
- 物理因果不可靠:物体不会真的遵守重力,只是“看起来像”。
- 可控编辑弱:改一个元素往往要重生成整段。
- 音画同步是独立问题,通常要另一套音频模型来配。
所以它在生产里的定位是预演、概念片、分镜、素材补充,而不是终版资产。这个定位和三维生成是一样的:能快速产出“看起来对”的东西,不等于能产出“可编辑、可复用、可交付”的东西。
8. 语音与音频基模:四件不同的事
这一类最容易被笼统说成“语音模型”,其实至少是四件事,训练目标和评价指标完全不同。
语音识别(ASR)。 Whisper 这一代的典型结构是编码器-解码器 Transformer,用海量弱标注音频训练,多语言、抗噪,但不是为流式设计的——它是听完一段再解码。做实时字幕要额外处理分块和延迟。
语音合成(TTS)。 目标函数从“预测文本”变成“预测声学特征再还原波形”。今天的重点已经是零样本音色克隆、情感与韵律控制,几秒钟参考音频就能模仿音色。风险也随之而来:伪造门槛大幅降低。
端到端语音对话。 把 ASR + LLM + TTS 合成一个模型,用离散音频 token(神经音频编解码器把波形压成码本)走语言模型的预测范式。核心指标不是准确率,是延迟和打断能力:端到端延迟要压到几百毫秒级,还要能判断对方是不是在说话。这是“能对话”和“像在对话”的分界线。
音乐与音效生成。 Suno、Udio、MusicGen、Stable Audio 这一支。结构和图像扩散很像(latent 上的生成),评价却高度主观,版权问题也最复杂。
共同边界:噪声与混响下的鲁棒性、说话人分离(多人同时说话)、口音与方言、以及长音频的一致性。工程上还要注意,音频的“一点错误”比图像的“一点错误”更容易被听出来——人对语音的异常极其敏感。
9. 三维基模:交付物决定一切
三维生成现在有三条主要路线,差别在“直接产出什么”:
- 多视图扩散 + 重建。 先生成多个视角的图,再用 SDF / NeRF / 3DGS 重建。质量稳定,速度慢,适合做静态物体。
- 前馈三维生成。 一次前向直接从图或文本回归三维表示(LRM 系、TripoSG、TRELLIS 这一类)。秒级出结果,是这两年真正的分水岭。
- 原生三维表示生成。 直接生成体素、点云、高斯或隐式场,再转成网格。可控性最好,但工具链最不成熟。
能力边界不在“像不像”,而在“能不能用”:拓扑是否干净、UV 是否规整、部件是否有语义、材质是否带 PBR 参数、能不能绑定骨骼做动画。这也是我在另一篇建模路线总结里的结论——外观资产已经能进生产,主角级、需要二次编辑的资产仍然要回到人工或参数化建模。
10. 世界模型与具身基模:从描述世界到预测世界
这一类是“基模”概念最近扩张最快的方向,因为它把目标从“生成内容”换成了“生成后果”。
视觉-语言-动作模型(VLA)。 输入是相机画面加指令,输出是动作(离散的动作 token 或连续控制量)。RT-2 的思路是把动作当成一种语言 token,让 VLM 直接输出;π0 这类工作改用流匹配的动作专家,输出连续轨迹,控制更平滑。它们的共同前提是大量遥操作数据或仿真数据。
世界模型。 目标是预测“如果我这么动,下一秒画面会变成什么”。Genie 这类工作从视频里学可交互的环境,Cosmos 这类工作把视频生成当成机器人和自动驾驶的合成数据引擎。
为什么这条路重要,理由不是“更酷”,而是数据:真实世界的动作数据极其昂贵,而一个足够可信的世界模型可以当仿真器用,让策略在里面试错。这条逻辑和当年用渲染器训自动驾驶是同一个思路。
边界也很硬:真机泛化(换个桌面、换个光照就失效)、长程任务(十几步之后就跑偏)、安全性(预测错一次可能撞到人)、以及 sim2real 的差距。所以今天它能落地的地方,基本是“有人监督、可回滚、失败代价低”的场景。
11. 三个窄而深的方向:科学、时序、表格
这三类不适合和上面的通用基模并列,但值得知道它们存在,因为它们说明了一件事:在结构化数值上,通用基模并不占优,领域先验仍然赢。
科学基模。 AlphaFold 系列解决的是从序列到结构的映射,ESM 系列把蛋白质序列当语言做自监督预训练,MACE / Orb 这类机器学习势函数直接拟合能量面,GraphCast / Pangu 把气象预报变成图网络或 Transformer 上的回归问题。共同点是几何等变、物理约束、数据量相对小但精度要求极高。它们不需要“什么都会”,只需要在一个狭窄分布上极其准确。
时序基模。 TimesFM、Chronos 这类做法是把数值序列切成 patch 或离散成 token,用类似语言模型的目标训练,然后零样本预测新序列。适用场景是“有一堆短序列、想快速拿到基线”;数据量大、周期结构明确的场景,传统统计模型和梯度提升树仍然很难被打败。
表格基模。 TabPFN 的思路很特别:用大量合成数据集预训练一个 Transformer,让它在前向时直接从上下文里“学会”这张表的规律,不做梯度更新。小表格、少样本的分类回归表现惊人,行数一多就退化。
这三个方向给通用基模的使用者一个提醒:如果你的任务是回归、分类、预测数值,先试试传统方法和专用模型,不要默认“上大模型”。
12. 横向对比:从工程角度看
同一张表换个角度——按“上手成本、能力上限、失败模式”来看,选型时更有用。
| 类别 | 上手成本 | 单次成本 | 能力上限 | 典型失败 |
|---|---|---|---|---|
| 语言基模 | 低 | 中 | 通用推理与编排 | 幻觉、格式脆、精确计算差 |
| 视觉表征 | 低 | 极低 | 检索与判别 | 细粒度、文字、属性绑定 |
| 视觉语言 | 低 | 中 | 读图与读屏 | 小字、计数、空间关系、过度自信 |
| 图像生成 | 中 | 中 | 外观与风格 | 精确布局、文字、一致性 |
| 视频生成 | 中 | 高 | 动态与镜头 | 时长、物理、可控编辑 |
| 语音音频 | 中 | 低到中 | 听说与克隆 | 噪声、分离、延迟、版权 |
| 三维 | 中高 | 中 | 形状与外观 | 拓扑、UV、材质、绑定 |
| 世界模型 / VLA | 高 | 高 | 闭环控制 | 泛化、长程、安全 |
| 科学 / 数值 | 高 | 低 | 特定分布内的高精度 | 分布外直接失效 |
13. 选型的五个问题
不必记模型名,记问题。按顺序问下来,答案会自动收敛。
第一,输出是否需要可验证的精确值? 需要数量、日期、坐标、金额、状态码,就把计算交给程序,让基模负责理解意图和组织结果。让语言模型直接算,是在用最不可靠的方式做最需要确定性的工作。
第二,是否需要理解私有或实时数据? 需要就先考虑检索、工具和结构化查询,其次才是微调。微调改的是行为,不是知识——用它来灌事实,通常既贵又不准。
第三,延迟和成本预算是多少? 交互式场景里,几百毫秒的差距就足以毁掉体验。这时候小模型 + 缓存 + 蒸馏,常常比大模型 + 排队更合适。
第四,是否必须本地部署? 涉及数据合规、离线环境、内网生产,就只能看开源权重和许可条款。注意许可证不只看“能不能商用”,还要看用户量门槛、再分发条件、以及衍生模型的约束。
第五,失败代价多大? 代价高就一定要有人审环节、评估集和灰度发布。基模的能力再强,也不改变“系统需要验证回路”这件事。
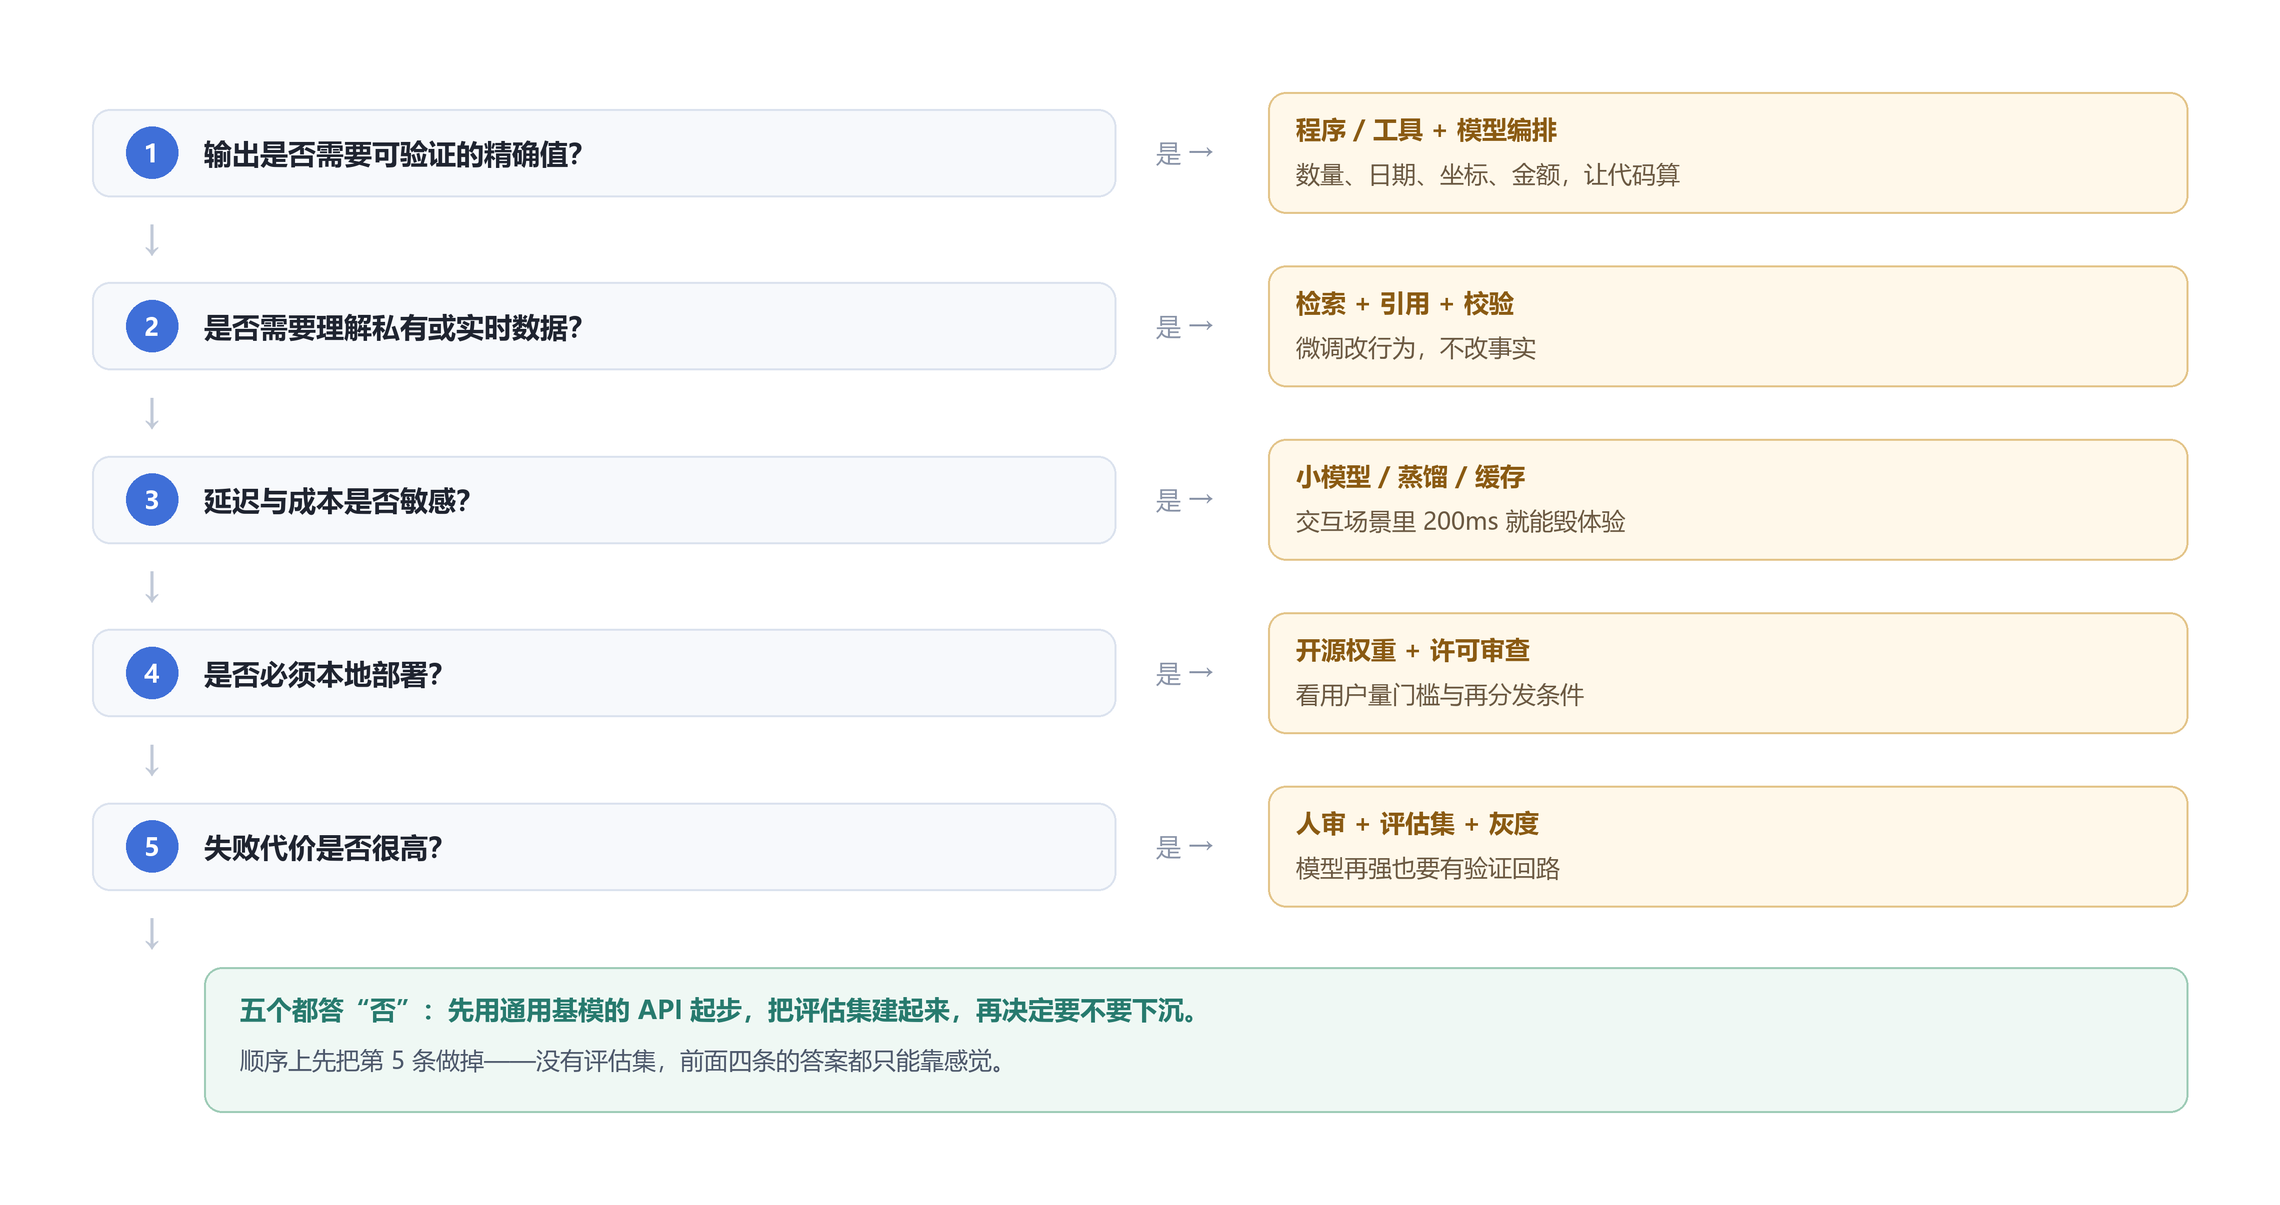
图 4 五个问题按顺序问一遍。任意一条答“是”,改的就是系统装配,而不是基模本身。
14. 基模决定什么,不决定什么
这是我认为最值得记住的一节。真实项目里的能力,大致按下面这个结构分布:
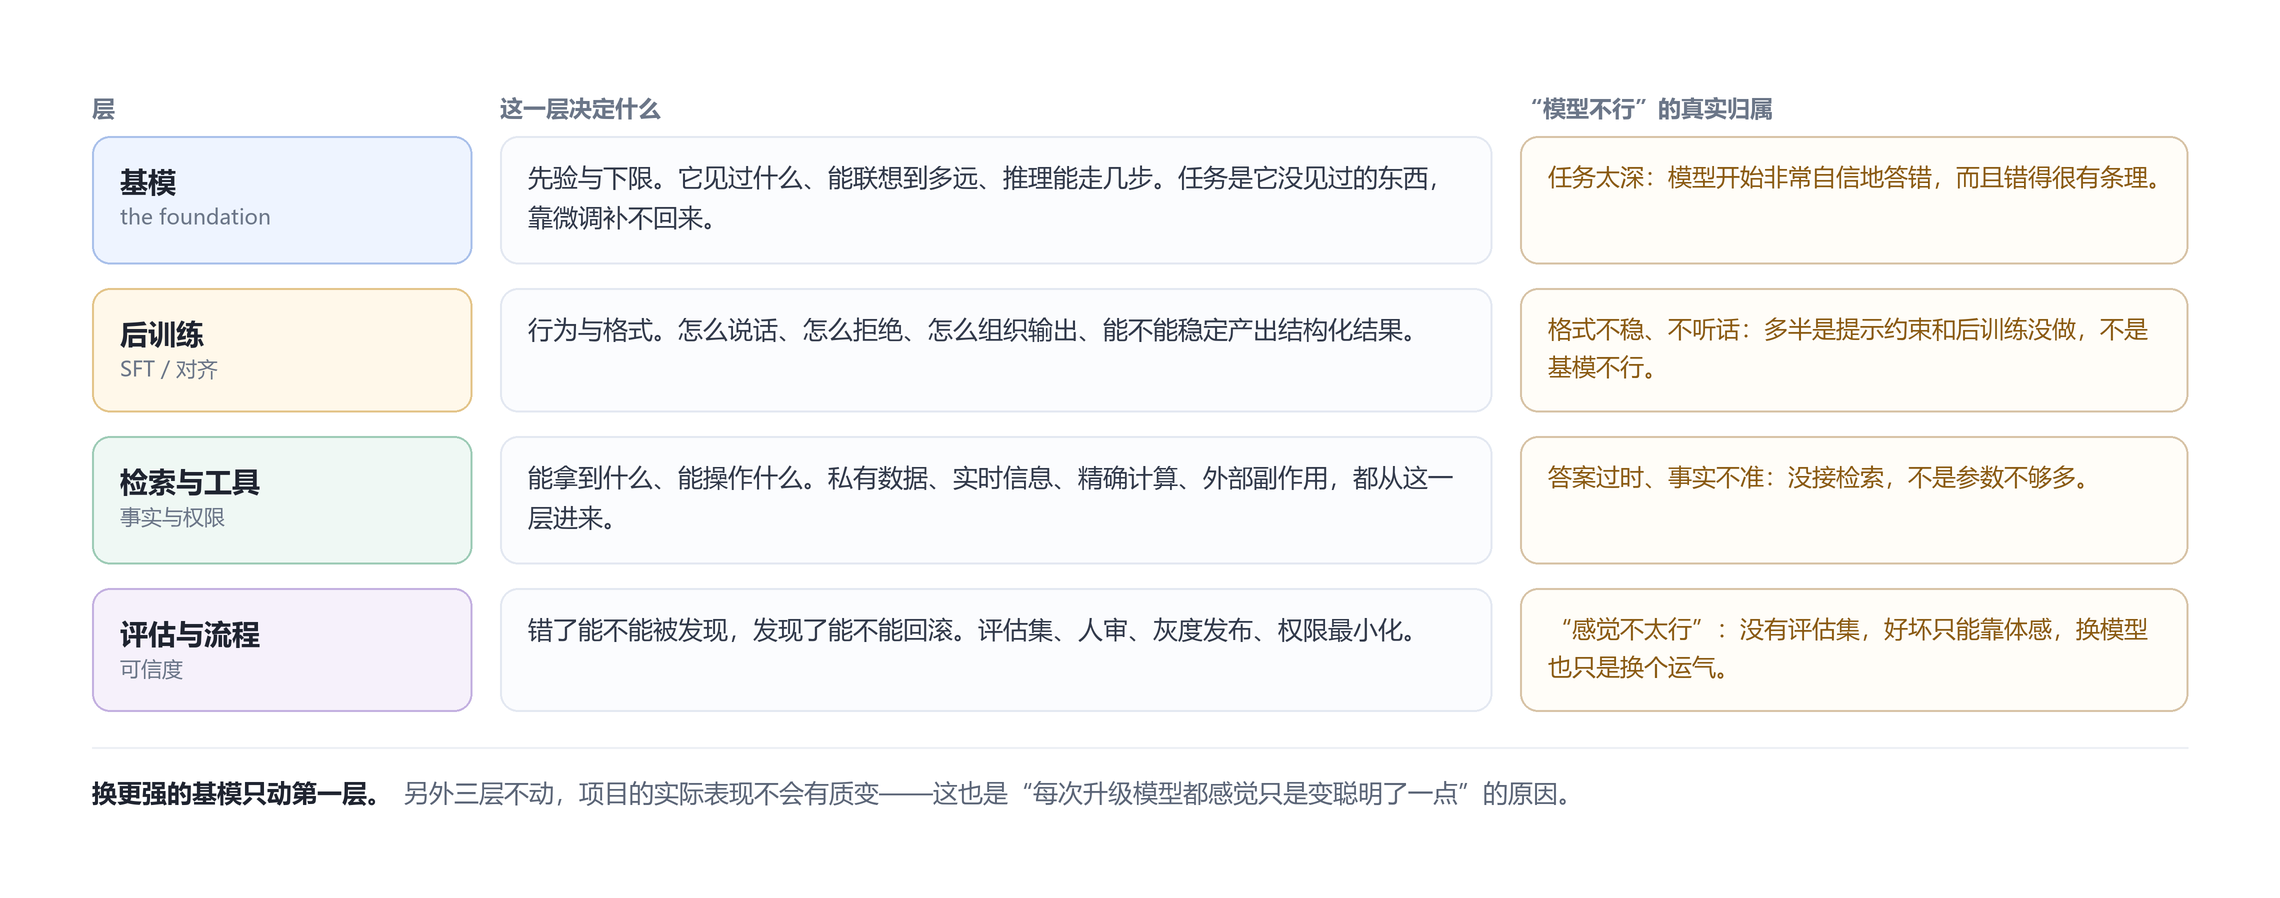
图 5 四层里只有第一层是基模的事。换一个更强的基模,动的是最上面那一层。
很多“模型不行”的抱怨,其实是第二层和第四层的问题。格式不稳,多半是指令微调和输出约束没做好;事实不准,多半是没接检索;输出不可信,多半是没有评估集。这些都不是换一个更大的基模能解决的。
反过来也一样:基模决定了下限。任务需要的推理深度超过模型能力时,再多的工程包装也只能让它更自信地答错。
15. 几个正在发生的变化
1. 原生多模态在取代拼接式多模态。 早期做法是“视觉塔 + 语言模型”,模态之间靠一个投影层连接,信息在连接处损耗。现在的方向是从预训练开始就把多种模态放进同一个目标函数里训练,输入输出都统一。差别会体现在跨模态的细节保留上,比如视频里的时序、图像里的文字。
2. 稀疏化和成本曲线。 MoE、蒸馏、量化、投机解码,这些工作的共同目标是把“能力”从“成本”里解耦出来。结果是大模型越来越像基础设施:能力不是瓶颈,单位成本才是。
3. 算力从训练移到推理。 推理模型证明了“多想一会儿”能换来正确率。这意味着模型能力不再是一个固定值,而是一个随预算变化的曲线。产品设计要处理的,是“什么时候值得多想”。
4. 基模开始承担 Agent 底座的职责。 长任务、记忆、工具调用、环境反馈,这些能力正在被直接训进基模,而不是在外部用工程拼。这会让“模型”和“系统”的边界变得更模糊。
5. 世界模型成为下一层底座。 如果视频生成足够可信,它就不只是内容工具,而是训练环境。这一层的成熟度,会直接决定具身智能的进度。
6. 许可与数据合规变成选型的硬约束。 训练数据的来源、模型输出的版权归属、开源许可的商用边界,这些过去被放在最后一页的问题,现在经常是第一页的否决项。
16. 总结
九类基模看起来分散,结构其实一样:一种编码、一份先验、一种解码。类别之间的差别,是“编码什么信号”和“还原成什么形式”。
所以判断一个新出现的模型,不必先记它的名字,问四个问题就够:
- 它吃进什么、吐出什么?
- 它用什么信号训练,这个信号让它擅长补全、判别,还是去噪?
- 它的中间表示能不能被别的系统复用?
- 它在什么分布外会失效?
这四个问题答完,它属于哪一类、边界在哪、该不该用,基本就清楚了。
最后重申开头那个区分:基模是底座,不是产品。底座决定了能力的天花板,产品的好坏还取决于后训练、检索、工具、评估和权限设计。把这两层混在一起谈,就会一直在“换个更强的模型”里打转,而真正卡住项目的往往是另外三层。
参考资料
- On the Opportunities and Risks of Foundation Models
- Attention Is All You Need
- Denoising Diffusion Probabilistic Models
- High-Resolution Image Synthesis with Latent Diffusion Models
- Scalable Diffusion Models with Transformers(DiT)
- Learning Transferable Visual Models From Natural Language Supervision(CLIP)
- DINOv2: Learning Robust Visual Features without Supervision
- Robust Speech Recognition via Large-Scale Weak Supervision(Whisper)
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
- π0: A Vision-Language-Action Flow Model for General Robot Control
- Accurate medium-range global weather forecasting with 3D neural networks(Pangu-Weather)
- Learning skillful medium-range global weather forecasting(GraphCast)
- Highly accurate protein structure prediction with AlphaFold
- Efficiently Modeling Long Sequences with Structured State Spaces
- A decoder-only foundation model for time-series forecasting(TimesFM)